# 给博客图片自动补上了 dimensions (March 14)
最近给这个博客处理了一下 markdown 图片的 width 和 height 属性的问题。
> 这篇文章一部分由 LLM 基于我的 git log 生成,非纯手写
>
 由于这个博客的文章不是写在文件里的,而是写在语雀上,用语雀当 CMS。也就是说,我本地并没有一堆 markdown 文件和配套的图片资源,文章内容是在运行时通过 API 拉下来的。图片来源也很散,有语雀自己的 CDN,有别的图床,也有 Open Graph 图。总之不是那种所有图片都躺在 `static/` 目录里的博客。
这样一来就有个问题:语雀返回给我的 HTML 里,`
![]() ` 基本没有 `width` 和 `height`。于是浏览器在图片真正加载出来之前,不知道该留多大位置,正文就会先排一版,等图片回来再重排。文章里图片多一点,页面就会抖。
而且这种博客架构下,也不可能手动给每张图维护尺寸。文章不在本地,图片来源又很散,这种事情一旦靠手工做,很快就会变成纯粹的脏活。
所以最后做的事就是:写一个脚本,在 build-time 把整个 blog 用到的图片尺寸都扫出来,生成一个 map 文件。运行时只负责查这个表。
---
## override `
![]() `
这个博客用的 markdown 渲染器 `@humanspeak/svelte-markdown`支持 override 各种元素对应的 component,比如可以 override `
![]() ` 标签。
所以先把 markdown 里的图片渲染接管了:
```jsx
```
这样所有 markdown 图片都会统一走 `Image.svelte`。
最后这个组件本身很薄,核心就这些:
```jsx
 ```
也就是说,问题的关键不再是怎么 render img,而是 `dimensions` 从哪来。
---
## 为什么我没有继续在运行时搞
最先想到的方案当然是运行时去拿。
比如:
+ 图片加载完之后再读它的 natural width / height
+ SSR 的时候顺手把每张图请求一遍
+ 自己再接管一套懒加载逻辑
但这些方案其实都不太对。
第一种太晚。等图片真的加载完了,布局早就重排了。
第二种太重。文章页如果有十几张图,那等于每次 render 页面都得顺手再请求十几次图片。
第三种一开始其实真写了,还加了 `IntersectionObserver` 和一些 fade-in 的状态。后来很快删了。因为它解决的是“什么时候加载”,不是“浏览器在 layout 的时候有没有尺寸信息”。原生的 `loading="lazy"` 已经够用了,没必要自己再维护一套状态机。
所以后来就把问题收束成了一件更具体的事:
> 只要能在页面渲染前拿到图片尺寸,这个问题就解决了。
>
---
## build-time 收集
既然文章内容本来就是从语雀拉下来的,那最自然的做法就是在 build-time 也走一遍类似的流程:
1. 列出 blog 仓库里的所有文章
2. 拉每篇文章的详情
3. 从 `body_html` 里抽出所有 `
![]() `
4. 请求这些图片
5. 读出它们的宽高
6. 写成一个 `image-dimensions.json`
这个脚本里真正新引入的核心依赖是 `image-size`。它做的事情很单纯:给它一段图片二进制,它返回宽高。
在代码里大概就是这样:
```typescript
const response = await fetch(url, { signal, headers: { "User-Agent": "Mozilla/5.0 (compatible; ImageSizeBot/1.0)" } });
const buffer = await response.arrayBuffer();
const dimensions = imageSize(new Uint8Array(buffer));
```
然后再检查:
```typescript
if (!dimensions?.width || !dimensions?.height) {
return { url, size: null, error: "Invalid image data" };
}
```
最后才把它变成我自己的统一格式:
```typescript
return { url, size: [dimensions.width, dimensions.height] };
```
这类事情当然也不是不能自己去读图片头,但没必要。既然已经有现成的库把这件事情做完了,而且常见格式都支持,那直接用就行了。
除此之外,这个脚本里还用了:
+ `cheerio`:解析语雀返回的 `body_html`,把所有图片地址抽出来
+ `xsfetch`:统一发请求
其中 `cheerio` 这一层也很朴素:
```typescript
const $ = cheerio.load(html);
$("img").each((_, elem) => {
const src = $(elem).attr("src");
if (src) {
imageUrls.add(src);
}
});
```
---
## `image-size` 之外,我还顺手把请求这一层补完整了
如果只是“请求图片然后喂给 `image-size`”,这个脚本其实会挺脆的。因为图床这东西本来就不稳定。
所以这里额外做了几件事:
### 超时
```typescript
const controller = new AbortController();
const timeoutId = setTimeout(() => {
controller.abort();
}, IMAGE_REQUEST_TIMEOUT_MS);
```
这样某张图太慢的时候,不至于把整个收集流程卡死。
### 重试
又包了一层 `fetchImageSizeAttempt`,对 408、425、429 以及 5xx 做重试。
```typescript
if (response.status === 404 || !isRetryableStatus(response.status) || attempt === IMAGE_REQUEST_RETRIES) {
return { url, size: null, error: lastError };
}
```
也就是说,404 这种明显没了的图就别浪费时间了,但如果只是服务端抖一下,那可以再试几次。
### 并发
没有直接 `Promise.all` 一把梭,而是自己写了个很小的 `AsyncQueue`,把“列文章”和“取图片尺寸”拆成两个队列。
一个队列负责 post,一个队列负责 image:
```typescript
const postQueue = new AsyncQueue();
const imageQueue = new AsyncQueue();
```
然后:
+ `POST_CONCURRENCY = 5`
+ `IMAGE_CONCURRENCY = 20`
这样做的好处是,文章详情和图片下载可以像流水线一样并发,而不是先把所有文章全扫完再开始下载图片。
这个设计我还挺喜欢的,很简单,但足够用。
---
## 我用到的语雀 API 其实很少
这个收集脚本基本只用了两类语雀 API。
先列出仓库里的文章:
```typescript
GET https://yuque.com/api/v2/repos/muspi_merol/blog/docs
```
再按 slug 拉详情:
```typescript
GET https://yuque.com/api/v2/repos/muspi_merol/blog/docs/:slug
```
真正有用的字段是 `body_html`,因为我要从里面找图片。
请求头也很简单:
```typescript
const headers = {
"User-Agent": "yuque-blog-bot",
"Accept": "application/json",
"X-Auth-Token": process.env.ACCESS_TOKEN || "",
};
```
所以整个数据流其实就是:
1. 通过语雀 API 列文章
2. 通过语雀 API 拉 `body_html`
3. 用 `cheerio` 抽 `
![]() `
4. 把图片下载下来
5. 用 `image-size` 读宽高
6. 输出成 JSON
---
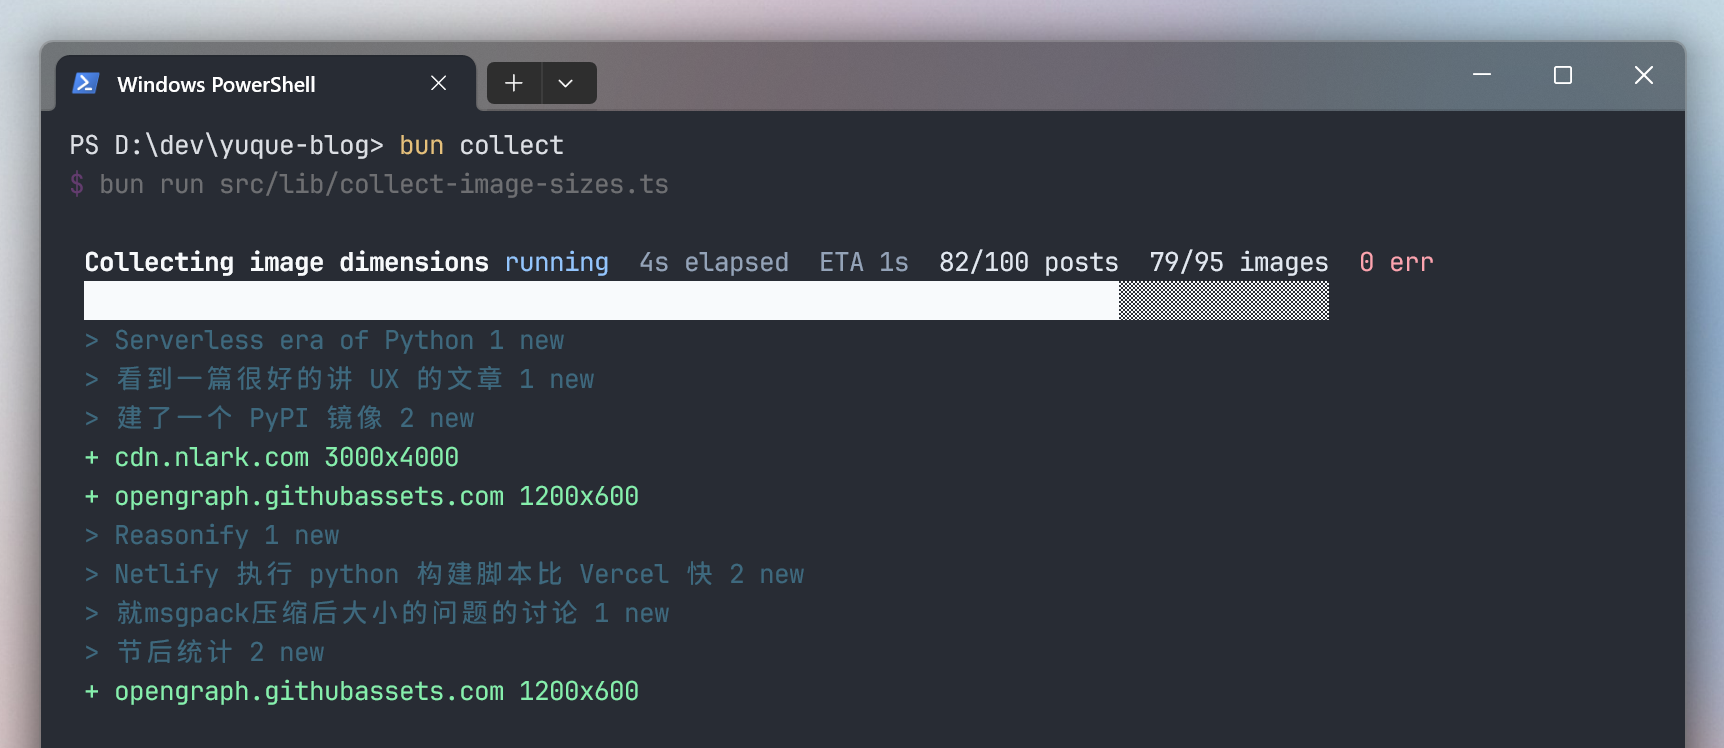
## 这个脚本里其实还有个我顺手手搓的 TUI
> 其实本来是想用 [OpenTUI](https://github.com/anomalyco/opentui) 的,只是后来发现 agnet 逐渐把 opentui 的东西都去掉了。主要是我想要实现类似 [prompt-toolkit](https://github.com/prompt-toolkit/python-prompt-toolkit) 的那种非 alternative screen 的 TUI
>
本来这东西完全可以只在命令行里 `console.log` 几行就算了,但后来还是单独写了个 `collect-image-sizes-ui.ts`。
这个文件里没有用什么 TUI 框架,而是直接用 ANSI escape code 自己画。
比如这些:
```typescript
const CSI = "\u001B[";
const ANSI_CODE = {
reset: "\u001B[0m",
hideCursor: "\u001B[?25l",
showCursor: "\u001B[?25h",
clearLine: "\u001B[2K",
} as const;
```
加上:
+ `moveToFrameStart(lineCount)`
+ `moveUp(lineCount)`
+ `clearLine`
就可以做到“把上一帧擦掉,再在原地重画下一帧”。
核心思路其实就是:
1. 维护一个内部 state
2. 根据 state 生成当前 frame 的所有行
3. 每次状态变化时,回到上一帧开头
4. 清掉旧内容
5. 把新 frame 全量写出来
`InlineCollectorUi` 就是这么干的。它里面维护了一份 `CollectorState`:
```typescript
interface CollectorState {
phase: string;
postsProcessed: number;
postsTotal: number;
imagesProcessed: number;
imagesTotal: number;
successCount: number;
failureCount: number;
startedAt: number;
finishedAt: number | null;
}
```
然后把这些状态拼成一帧:标题、进度条、日志。
其中那个进度条也不是现成库给的,而是自己按宽度算出来的:
```typescript
const scanWidth = Math.min(Math.floor(scanProgress * width), width);
const imageWidth = Math.min(Math.floor(imageProgress * width), scanWidth);
```
再用:
```typescript
FILLED_BAR_CHAR.repeat(imageWidth)
SCAN_BAR_CHAR.repeat(pendingWidth)
TRACK_BAR_CHAR.repeat(trackWidth)
```
拼出一条 pipeline bar。
我这里还顺手做了两套 UI:
+ 如果当前终端不是 TTY,就退回到 `ConsoleCollectorUi`,直接普通输出
+ 如果是交互终端,就用 `InlineCollectorUi` 做原地刷新
也就是说它不是为了“好看”才单独写个 TUI,而是为了让这个 collector 在不同环境下都还能有比较合理的表现。
---
## 生成的尺寸表
最后写出来的文件大概长这样:
```json
{
"/nlark/yuque/0/2025/png/26070246/....png": [2984, 1651],
"/nlark/yuque/0/2025/webp/26070246/....webp": [1320, 1180]
}
```
然后在 `Image.svelte` 里 eager import:
```typescript
const imageDimensionsModules = import.meta.glob("./image-dimensions.json", { eager: true });
const dimensionsMap = Object.values(imageDimensionsModules)[0]?.default ?? {};
```
再按地址去查:
```typescript
const dimensions = $derived(
!href
? undefined
: dimensionsMap[href] || dimensionsMap[`/nlark/${href.replace(/^\/nlark\//, "")}`],
);
```
这里还有一个小问题要处理:我页面里有些图片地址走的是 `/nlark/...` 这个代理路径,但收集尺寸的时候拿到的是真实的 CDN 地址。所以查表的时候要兼容这两种写法。
这不是什么很高级的东西,但这是这种项目里很典型的小脏活。
---
## 结语
这个方案我觉得比较舒服的一点是,它完全向后兼容且 type-safe。我 git 上提交的 dimensions 文件是一个空的 `{}`,而每当在 vercel / netlify 上 build 的时候就会去尽可能地 fetch 这些图片并记录每一个图片 url 对应的宽高。